Русский текст стоит дороже
На Хабре прогнали один и тот же русский текст через одиннадцать токенизаторов языковых моделей и получили разброс в пять раз: у одной модели в токен помещается одна русская буква, у другой пять. В рублях тысяча русских символов входного текста у Claude Opus 5 стоит в 3,15 раза дороже тысячи английских, а у YandexGPT и GigaChat почти столько же, сколько английская.
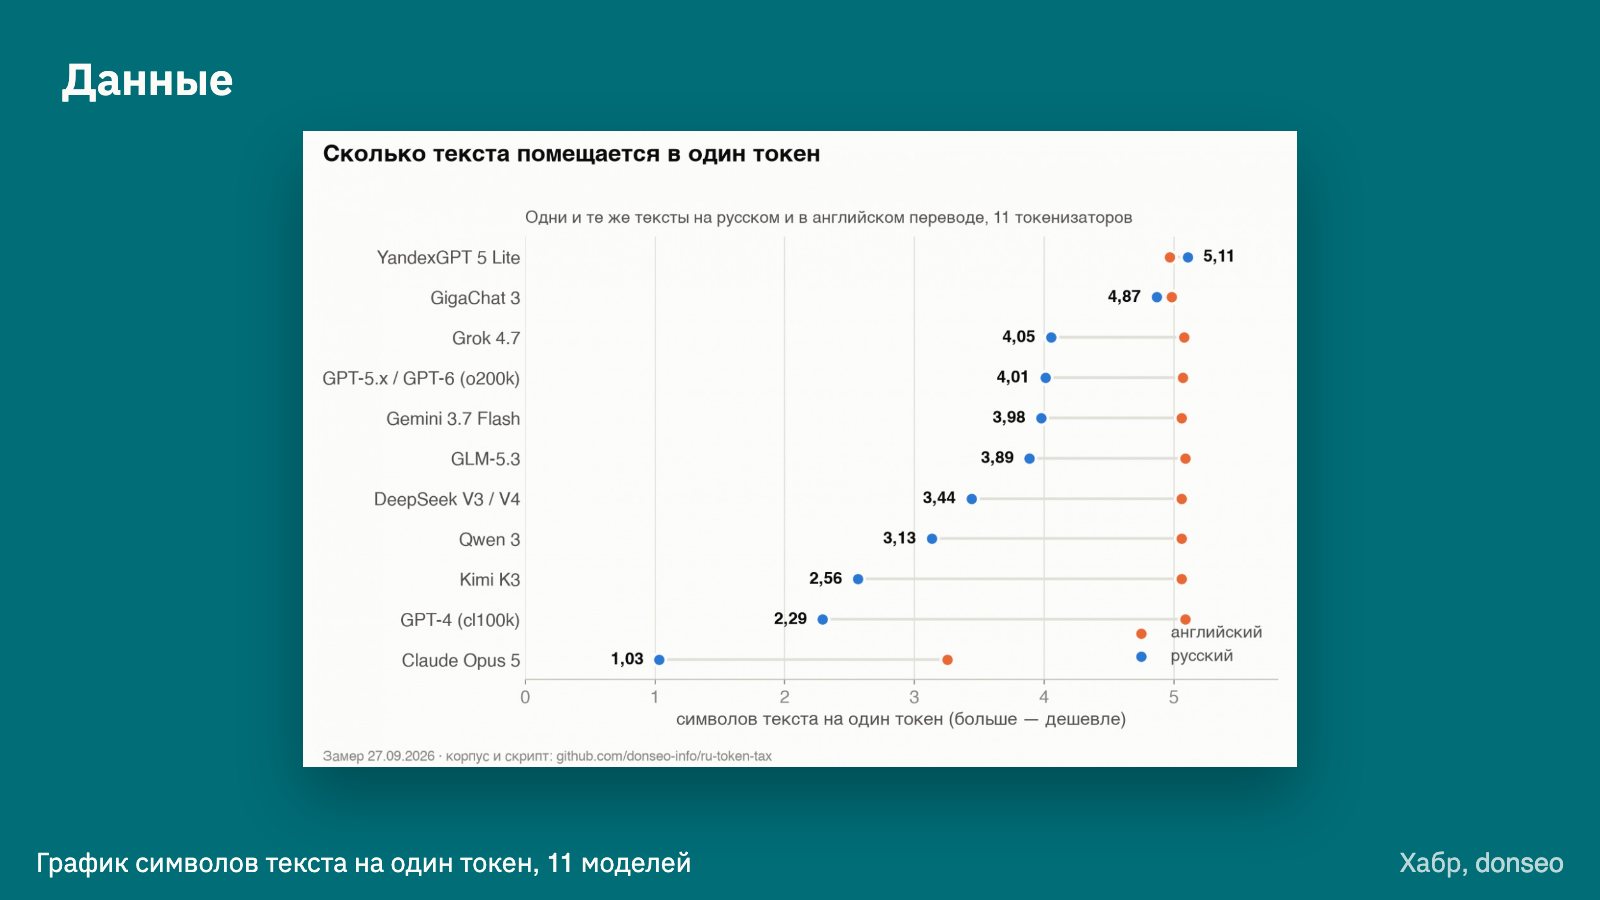
1 октября автор Хабра под псевдонимом donseo прогнал один и тот же русский текст через токенизаторы GPT, Claude, Gemini, DeepSeek, Qwen, GLM, Kimi, Grok, GigaChat и YandexGPT. Токенизатор работает как алгоритм, который режет текст на кусочки, токены, перед тем как подать его в нейросеть; именно за токены, а не за слова или символы, большинство сервисов берет плату. Результат: Claude Opus 5, топовая модель компании Anthropic, насчитала в русском тексте в 3,9 раза больше токенов, чем GPT-5.5 от OpenAI. По медианным ценам агрегаторов цена за токен у обеих моделей сопоставима, значит, один и тот же русский текст на Opus 5 обойдется почти вчетверо дороже.
Для русского текста большинство токенизаторов устроены хуже, чем для английского: одни режут слово на два-три куска вместо одного, другие доходят до того, что почти каждая буква кириллицы становится отдельным токеном.
Что замерили на Хабре
Автор взял четыре пары параллельных текстов: русский оригинал и его английский перевод того же смысла, в жанрах технической статьи, диалога с поддержкой, делового уведомления и программного кода с комментариями. Для моделей с открытым токенизатором (GigaChat, YandexGPT, DeepSeek, Qwen и старые версии GPT) токены посчитали прямым запуском библиотеки токенизатора. Для моделей с закрытым токенизатором (Claude, Gemini, Grok, Kimi, GLM) число токенов вычислили по разнице двух запросов к API (программному интерфейсу сервиса): один запрос содержал только короткую служебную инструкцию «ответь одним словом: ок», второй — ту же инструкцию и сам исследуемый текст. Разность числа входных токенов между двумя запросами и дала оценку длины текста. Метод проверили на моделях, где можно сравнить оба способа счета, и получили точное совпадение.
| Модель | Симв. на токен, русский | Симв. на токен, английский | Русский длиннее английского, раз |
|---|---|---|---|
| YandexGPT 5 Lite | 5,11 | 4,97 | 0,91 (короче) |
| GigaChat 3 | 4,87 | 4,98 | 0,96 (короче) |
| Grok 4.7 | 4,05 | 5,08 | 1,18 |
| GPT-5.x / GPT-6 (o200k) | 4,01 | 5,07 | 1,19 |
| Gemini 3.7 Flash | 3,98 | 5,06 | 1,20 |
| GLM-5.3 | 3,89 | 5,09 | 1,23 |
| DeepSeek V3 / V4 | 3,44 | 5,06 | 1,38 |
| Qwen 3 | 3,13 | 5,06 | 1,52 |
| Kimi K3 | 2,56 | 5,06 | 1,86 |
| GPT-4 / GPT-3.5 (cl100k) | 2,29 | 5,09 | 2,09 |
| Claude Opus 5 | 1,03 | 3,25 | 2,96 |
Последняя колонка показывает, во сколько раз больше токенов займет тот же смысл по-русски. У российских моделей она меньше единицы, у Claude Opus 5 почти три, причем и английский Opus 5 режет мельче других, 3,25 символа на токен против обычных пяти.
Пять символов против одной буквы: пересчет в рубли
Автор публикации перевел разницу в токенизации в рубли за тысячу символов входного текста, взяв медианную цену за миллион токенов по каталогу цен сервисов с доступом из России на 27 сентября 2026 года.
| Модель | ₽ за 1000 симв. RU | ₽ за 1000 симв. EN | Русский дороже, раз |
|---|---|---|---|
| DeepSeek V4 Flash | 0,0043 | 0,0029 | 1,47 |
| GPT-5.6 Luna | 0,0059 | 0,0047 | 1,26 |
| Gemini 3.7 Flash | 0,0209 | 0,0164 | 1,27 |
| Qwen3 Max | 0,0300 | 0,0186 | 1,61 |
| GLM-5.3 | 0,0342 | 0,0262 | 1,31 |
| DeepSeek V4 Pro | 0,0435 | 0,0296 | 1,47 |
| YandexGPT 5 Lite | 0,0529 | 0,0544 | 0,97 |
| Grok 4.6 | 0,0581 | 0,0464 | 1,25 |
| Kimi K3 | 0,1112 | 0,0564 | 1,97 |
| GPT-5.5 | 0,1377 | 0,1089 | 1,26 |
| GigaChat 2 Max | 0,2561 | 0,2500 | 1,02 |
| Claude Opus 5 | 0,5318 | 0,1690 | 3,15 |
Цифры из поста в Telegram-канале «AI для бизнеса», 0,53 и 0,14 рубля, взяты из этой таблицы: столько стоит тысяча русских символов у Claude Opus 5 и у GPT-5.5. Из таблицы автор Хабра выводит, что разрыв между российскими и зарубежными моделями на русском языке меньше, чем кажется по прайсу: GigaChat 2 Max по цене за токен дороже GPT-5.5 в 2,3 раза, а по цене за тысячу русских символов дороже только в 1,9 раза, YandexGPT 5 Lite за токен вдвое дешевле GPT-5.5, а за тысячу русских символов дешевле уже в 2,6 раза. Для двух моделей из таблицы расчет приближенный: цену GigaChat 2 Max считали по открытому токенизатору GigaChat 3, а Grok 4.6 — по токенизатору Grok 4.7, отдельных данных по токенизаторам именно этих версий автор не нашел. Сами цены — медианы по каталогу агрегатора на одну дату, а не прямой тариф разработчика.
Откуда взялся языковой налог
Неравенство токенизаторов между языками измерили еще в 2023 году в двух научных работах; его часто называют «языковым налогом» (language tax). Александар Петров с коллегами из Оксфордского университета опубликовали на конференции NeurIPS работу «Токенизаторы языковых моделей вносят неравенство между языками»: авторы показали, что один и тот же текст, переведенный на разные языки, может различаться по длине в токенах до 15 раз, и это расхождение сохраняется даже у токенизаторов, которые специально обучали как многоязычные. Другая команда, Ореваогене Ахия с коллегами из университета Вашингтона и других университетов, в том же году опубликовала на конференции EMNLP работу «Одинаково ли стоят все языки? Токенизация в эпоху коммерческих языковых моделей»: там показано, что языки с собственной непривычной для модели письменностью (авторы приводят в пример язык телугу) требуют до 5 раз больше токенов, чем языки на основе латиницы, при том же смысле текста. Обе работы уже тогда предлагали поставщикам API пересмотреть ценообразование так, чтобы оно не наказывало пользователей одного языка сильнее, чем пользователей другого.
Токенизаторы большинства западных моделей построены по алгоритму BPE (byte pair encoding): он ищет самые частые сочетания символов в обучающих данных и назначает им отдельные токены. Если в обучающей выборке подавляющее большинство текста на английском, частыми сочетаниями становятся английские слоги и целые слова, а кириллица в словарь почти не попадает. Более старая публикация на Хабре об этом же явлении приводит точную цифру для токенизатора cl100k_base, которым пользуются GPT-4 и GPT-3.5: из 100 235 токенов в его словаре кириллических всего 435. Переход OpenAI на новый токенизатор o200k_base в модели GPT-4o сократил число токенов на русском языке почти вдвое, 2,29 символа на токен выросли до 4,01, при этом английский почти не изменился (5,09 и 5,07 символа на токен). До GigaChat и YandexGPT, у которых русский режется по 4,87 и 5,11 символа на токен, новый токенизатор OpenAI все равно не дотягивает.
Собственная проверка на одном предложении
Открытые токенизаторы OpenAI распространяются как библиотека tiktoken и считают токены за секунды без обращения к API, поэтому замер легко повторить. Для проверки взяли одно предложение на русском и его перевод на английский того же смысла: «Редакция обсудила заголовок будущей статьи, выбрала три примера из практики клиентов и отправила черновик на вычитку главному редактору до конца недели» (151 символ) и «The editorial team discussed the headline for the upcoming article, picked three examples from client practice, and sent the draft to the chief editor for review before the end of the week» (188 символов).
На токенизаторе o200k_base, которым считает GPT-5.x и GPT-6, русский текст занял 40 токенов против 34 у английского, то есть на 18% больше. На устаревшем cl100k_base, которым считает GPT-4, разрыв выше: 60 токенов на русском против тех же 34 на английском, на 76% больше. У Хабра на тех же токенизаторах вышло 1,19 и 2,09 раза: там считали по трем прозаическим парам из четырех, длиной около тысячи символов, здесь по одному предложению в 150-190 символов, а короткий текст сильнее зависит от конкретных слов.
Как посчитать, во что обойдется русский текст
Сравнивать модели надежнее по цене типичного запроса: для этого реальные тексты проекта прогоняют через токенизаторы двух-трех моделей.
Если английские тексты обходились в 10 000 рублей в месяц, тот же объем символов по-русски по ценам из таблицы стоит около 12 600 рублей на GPT-5.5 и около 31 500 рублей на Claude Opus 5.
Служебную часть промпта (системную инструкцию, описание инструментов, схему JSON) можно держать на английском языке, если модель плохо токенизирует русский: это сокращает число входных токенов на каждом запросе. Экономия токенов не гарантирует то же качество ответа: системная инструкция и описание инструментов влияют на результат, даже если пользователь их не видит. После перевода стоит сравнить русскую и английскую версии на одинаковых задачах и проверить, сохраняются ли качество ответа и соблюдение требований. Пользовательский текст и ответ модели при этом остаются русскими.
Здесь посчитана только обработка входного текста: вопрос, который пользователь или скрипт отправляет модели. Для бюджета на генерацию контента и рекламных текстов отдельно прибавьте стоимость ответа: число выходных токенов умножьте на тариф за них, который у большинства моделей выше входного.
Цифры в личном кабинете агрегатора стоит сверять, если на них строится биллинг клиента. В замере на Хабре у части моделей число токенов, посчитанное одним посредником, не совпало с официальным токенизатором разработчика: среди возможных причин автор называет собственный пересчет шлюза и то, что запрос уходил не к той модели, которая указана в интерфейсе. Сверить несложно: у OpenAI это открытая библиотека tiktoken, у Anthropic это отдельный бесплатный эндпоинт для подсчета токенов в API.
Где русский текст стоит почти как английский
Почти по цене английского русский текст в этой таблице выходит только у моделей, которые делали под русский язык: у YandexGPT 5 Lite тысяча русских символов на 3% дешевле тысячи английских, у GigaChat 2 Max на 2% дороже. Самым дешевым по абсолютной цене в таблице остается DeepSeek V4 Flash, 0,0043 рубля за тысячу русских символов, хотя русский у него на 47% дороже английского.
Коротко
Во сколько раз русский текст у Claude Opus 5 дороже английского? Почти втрое: русский текст занимает в 2,96 раза больше токенов, чем английский перевод того же смысла, а тысяча русских символов стоит в 3,15 раза дороже тысячи английских.
У каких моделей русский текст не длиннее английского? У YandexGPT 5 Lite и GigaChat 3: они делались под русский язык, и русский текст у них занимает даже немного меньше токенов, чем английский перевод того же смысла. По ценам из замера тысяча русских символов у YandexGPT 5 Lite стоит чуть дешевле тысячи английских.
Откуда взялся «языковой налог» на русский язык? Токенизаторы большинства моделей обучены в основном на английском тексте: в словаре cl100k_base, которым считает GPT-4, из 100 235 токенов кириллических всего 435.
Как проверить заранее, во что обойдется русский текст? Прогнать свой реальный текст через токенизатор модели — у OpenAI это открытая библиотека tiktoken, у Anthropic отдельный бесплатный эндпоинт — а не ориентироваться на цену за миллион токенов из прайса.
Можно ли сэкономить на токенах без потери качества ответа? Служебную часть промпта можно держать на английском, если модель плохо токенизирует русский, но после этого нужно сравнить ответы на обоих языках и проверить, что качество и выполнение требований не упали.
Источники: Хабр, donseo, «Русский текст в Claude Opus 5 стоит в 3,9 раза дороже, чем в GPT-5.5, при одинаковой цене за токен», 01.10.2026, habr.com/ru/articles/1089148/; Хабр, «Кириллица в LLM: почему русский язык в нейросетях стоит дороже и работает медленнее», habr.com/ru/articles/1032610/; A. Petrov, E. La Malfa, P. H. S. Torr, A. Bibi, «Language Model Tokenizers Introduce Unfairness Between Languages», NeurIPS 2023, arXiv:2305.15425, также proceedings.neurips.cc; O. Ahia, S. Kumar, H. Gonen, J. Kasai, D. Mortensen, N. Smith, Y. Tsvetkov, «Do All Languages Cost the Same? Tokenization in the Era of Commercial Language Models», EMNLP 2023, aclanthology.org/2023.emnlp-main.614; OpenAI, библиотека tiktoken, github.com/openai/tiktoken, кодировки o200k_base и cl100k_base; Anthropic, официальный эндпоинт подсчета токенов для API Claude, docs.anthropic.com; radarii.ru, «Цены API GigaChat и Alice AI 2026: тарифы, рейтинг»; developers.sber.ru, тарифы GigaChat API с 1 февраля 2026 года; yandex.cloud и aistudio.yandex.ru, тарифы YandexGPT API; каталог цен AI-Ping, упомянутый в публикации Хабра как источник медианных цен на 27.09.2026; репозиторий ru-token-tax автора donseo с текстами и скриптом замера, упомянутый в конце статьи на Хабре; CNews, «Америка наживается на россиянах. Российские запросы в Claude вчетверо дороже американских», 05.10.2026, cnews.ru; vc.ru, «Русская буква всегда стоила дороже. CNews это только что „открыл“», vc.ru/id6137000/3178628; Pachca AI Digest, пересказ публикации Хабра, 01.10.2026, pachca.com/ai-digest.
Материал вошел в выпуск № 7, 29 ноября 2026. Все выпуски